
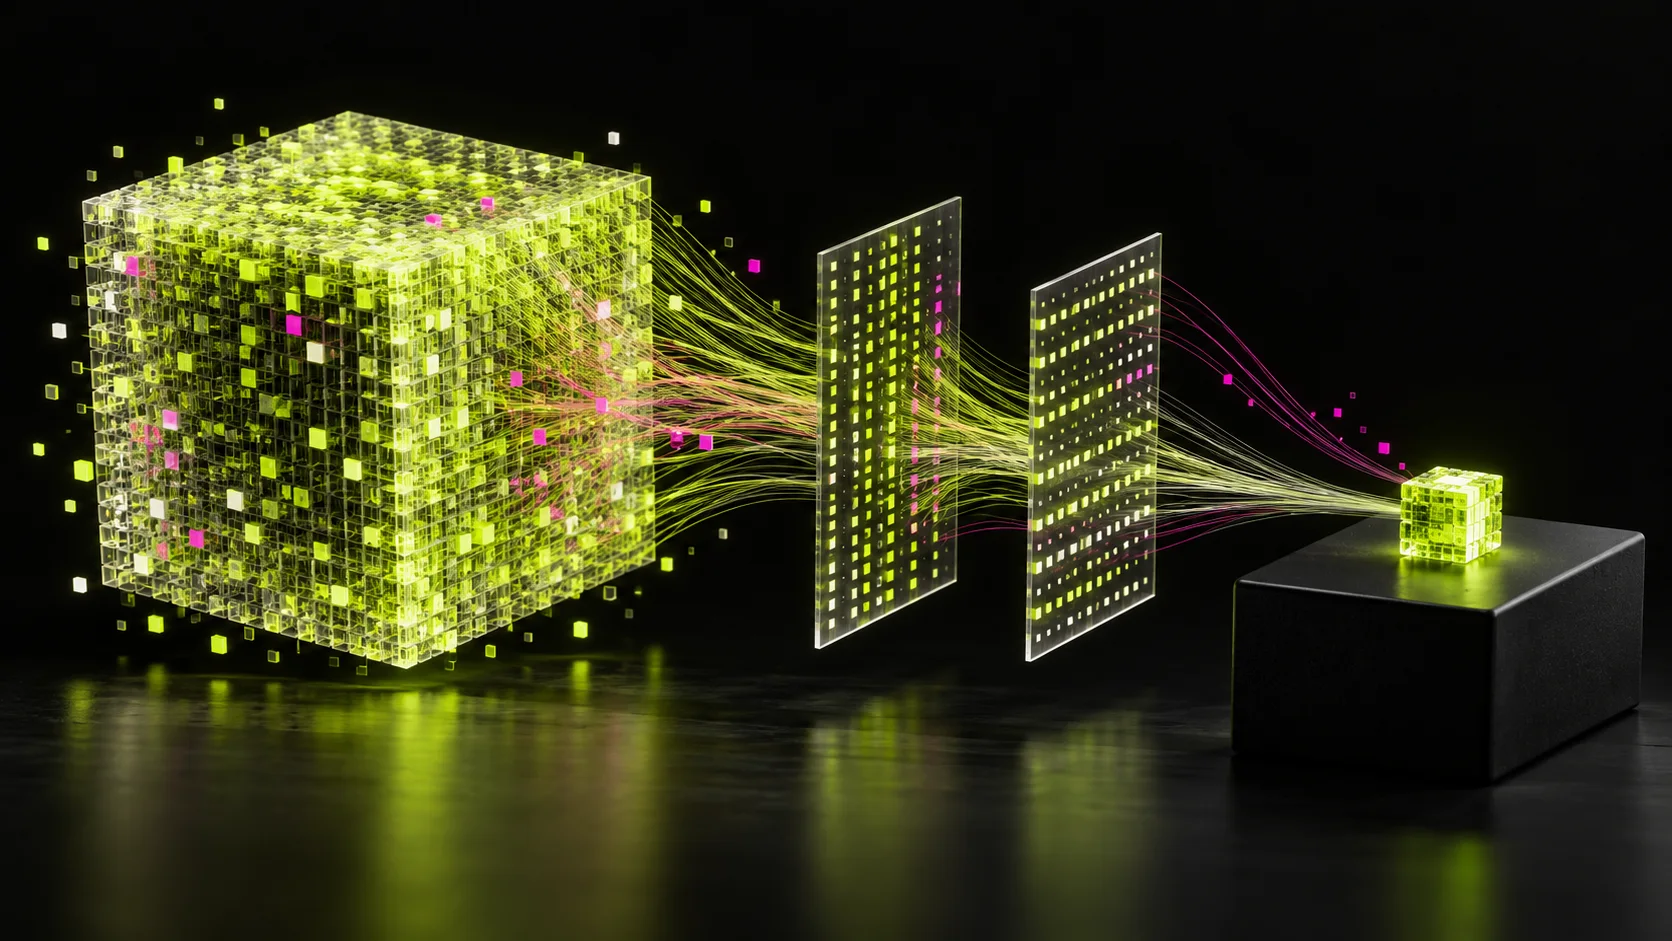
Samsung LittleBit: Was KI unter 1 GB für Unternehmen bedeutet
Ein großes Sprachmodell auf kleiner Hardware: Samsungs LittleBit macht diese Perspektive greifbarer. Für Unternehmen wäre das mehr als ein beeindruckender Speicherrekord. Wenn brauchbare KI weniger Ressourcen braucht, könnten zusätzliche Aufgaben direkt am Arbeitsplatz oder am Ort ihrer Entstehung verarbeitet werden. Die entscheidende Frage bleibt: Welche Qualität kommt nach der Kompression noch beim Anwender an?
Redaktionsstand: 9. Oktober 2026. Das Paper erschien erstmals am 30. Mai 2025; die aktuelle arXiv-Fassung ist vom 5. Februar 2026. „Gerade veröffentlicht“ trifft deshalb nicht zu. Veröffentlichungshistorie bei arXiv.
Die Zahlen hinter LittleBit – mit dem richtigen Maßstab
Die Forschenden von Samsung Research nennen für Llama2-13B bei 0,1 Bits pro Gewicht 0,84 GB Modellspeicher statt 26,06 GB in FP16. Embeddings und Ausgabeschicht bleiben dabei in FP16. Das ist keine Messung des gesamten RAM-Bedarfs einer laufenden Anwendung. Paper, Tabelle 3 und Analyse.
Die 11,6-fache Beschleunigung betrifft einen Kernel für eine Llama2-70B-MLP-Schicht auf einer NVIDIA A100. Daraus folgt kein entsprechender End-to-End-Speedup für einen Chatbot. Auch Qualität geht verloren: Auf WikiText-2 steigt die Perplexity von Llama2-13B von 4,88 auf 15,09 bei 0,1 BPW; niedriger ist besser. Paper, Abbildung 6 und Tabelle 1.
Was bedeutet weniger als ein Bit pro Gewicht?
LittleBit zerlegt Gewichtsmatrizen in kleinere binäre Faktoren. Gelernte Skalierungen und ein Korrekturpfad gleichen Näherungsfehler aus. Vorzeichenoperationen vereinfachen Berechnungen; Skalierungen und weitere Rechenoperationen bleiben nötig. Die Aussage, die KI müsse „nicht mehr rechnen“, führt deshalb in die Irre. Methodik im Paper.
Zur Einordnung des Begriffs: Ein effektiver Durchschnitt unter einem Bit bedeutet nicht, dass ein einzelner Speicherplatz plötzlich ein Zehntel eines Bits enthält. Wenn sich viele ursprüngliche Werte durch eine kleinere gemeinsame Darstellung annähern lassen, sinkt der Speicherbedarf pro ursprünglichem Gewicht. Man kann sich das wie eine ausführliche Tabelle vorstellen, deren regelmäßige Muster durch wenige Regeln beschrieben werden. Wie gut diese Regeln die Ausnahmen erfassen, entscheidet über den Informationsverlust.
Für einen betrieblichen Einsatz muss die Messung deshalb über die Dateigröße hinausgehen. Kontext, Zwischenergebnisse, parallele Anfragen und die Laufzeitumgebung gehören in den Speichertest. Ein kleines Modellartefakt allein beantwortet noch nicht, wie viele Mitarbeitende gleichzeitig damit arbeiten können.
Was im Oktober 2026 aktuell ist: LittleBit-2 und öffentlicher Code
Das offizielle SamsungLabs-Repository führt inzwischen LittleBit-2 als Folgearbeit zur ICML 2026. Die optionale Joint-ITQ-Initialisierung richtet die latenten Faktoren vor dem quantisierungsbewussten Training günstiger aus. Laut Projekt bleibt die Inferenzstruktur dabei unverändert.
Das Repository enthält Trainings- und Evaluationsanleitungen. Es nennt unter anderem Llama, Phi-4, Qwen und Gemma als unterstützte Modellfamilien. Öffentlich verfügbar heißt hier allerdings nicht pauschal kommerziell frei nutzbar: Das Projekt nennt CC BY-NC 4.0. Für einen geschäftlichen Einsatz müssen Nutzungsrechte geklärt werden. Die Veröffentlichung von Forschungscode ist außerdem noch kein Nachweis einer fertigen Integration in den eigenen Produktionsstack.
Warum der Vergleich mit Kimi-K3 auf einem DGX Spark zu weit geht
Der Vergleich aus dem kursierenden Beitrag ist eine Hochrechnung, kein in der verlinkten Studie belegtes Deployment. Von einem Kompressionsverfahren auf ein anderes Modell und anschließend auf ein bestimmtes Gerät zu schließen, überspringt mehrere Prüfungen: Passt die Modellarchitektur? Bleibt die Qualität erhalten? Gibt es eine passende Implementierung? Reicht der Durchsatz bei realer Kontextlänge?
Unsere Einordnung: Solche Analogien können eine Forschungsrichtung anschaulich machen. Als Grundlage für eine Hardwarebestellung sind sie zu ungenau. Für die grundsätzliche Architekturentscheidung ergänzt unser Beitrag zu lokaler KI, DGX Spark und Infrastruktur die Perspektive.
Wo kompakte lokale KI im Unternehmen helfen könnte
Der wirtschaftliche Nutzen entsteht an einer konkreten Aufgabe. Als mögliche Testszenarien bieten sich beispielsweise an:
- Dokumente vorsortieren: Eingehende Dateien Kategorien zuordnen und unsichere Fälle an Menschen übergeben. Messen lassen sich Fehlzuordnungen und eingesparte Bearbeitungszeit.
- Servicetickets vorbereiten: Anliegen strukturieren und einen Antwortentwurf erzeugen. Entscheidend sind Korrekturbedarf und Zeit bis zur Freigabe.
- Interne Informationen erschließen: Antworten aus freigegebenen Unterlagen vorbereiten. Quellenbezug und belastbares Ablehnen unbeantwortbarer Fragen gehören in die Abnahme.
Das sind mögliche Einsatzfelder, keine von uns behaupteten LittleBit-Projektergebnisse. Ein kleineres Modell wäre dort wertvoll, wo die Aufgabe klar begrenzt ist und Fehler zuverlässig erkannt werden. Für komplexe Ausnahmen kann eine Übergabe an ein stärkeres Modell oder an einen Menschen sinnvoll sein.
So wird aus dem Forschungsergebnis ein belastbarer Pilot
Bei Agentifizierung würden wir die Entscheidung entlang eines konkreten Ablaufs vorbereiten: zuerst Aufgabe und Abnahmekriterien festlegen, dann eine Baseline messen und erst anschließend die komprimierte Variante unter denselben Bedingungen vergleichen.
- Reale Fälle zusammenstellen: typische Aufgaben, schwierige Ausnahmen und Beispiele, bei denen das System ablehnen muss.
- Gegen dieselbe Baseline testen: identische Eingaben und Bewertungsregeln für eine heute nutzbare Lösung und den Forschungskandidaten.
- Die ganze Anwendung messen: Spitzen-RAM, Antwortzeit, Durchsatz, Korrekturbedarf und Aufwand für den laufenden Betrieb.
- Eine Entscheidung treffen: weiterentwickeln, eine weniger starke Kompression wählen oder beim bestehenden Ansatz bleiben.
Die relevante Zielgröße ist der Aufwand pro korrekt erledigtem Vorgang. Eine beeindruckende Kompressionsrate hilft wenig, wenn zusätzliche Nacharbeit den Vorteil aufzehrt. Wenn Sie einen konkreten Prozess für lokale KI prüfen möchten, beschreibt unser KI-Agenten-Pilot den Weg zu einer messbaren Entscheidung. Im Agentifizierungs-Check können Sie die Ausgangslage schildern.
Häufige Fragen zur Entscheidung für lokale KI
Was sollte ein Team vor dem ersten Test festlegen?
Eine eng begrenzte Aufgabe, repräsentative Testfälle und eine verantwortliche Person für die Abnahme. Dazu gehören klare Regeln dafür, wann das System antworten, ablehnen oder an Menschen übergeben soll.
Wann lohnt sich zusätzliche Kompression?
Wenn Speicher oder Durchsatz den gewünschten Einsatz verhindern und die komprimierte Variante die fachlichen Abnahmekriterien weiterhin erfüllt. Der Vergleich sollte auch Integration und laufende Betreuung berücksichtigen.
Sollten Unternehmen auf den nächsten Durchbruch warten?
Ein klar definierter Prozess lässt sich bereits mit einer verfügbaren Baseline prüfen. Ein austauschbarer Modellzugang erleichtert später den Vergleich neuer Verfahren, ohne den gesamten Ablauf neu aufzubauen.
Quellen und redaktionelle Einordnung
- LittleBit: Ultra Low-Bit Quantization via Latent Factorization – Veröffentlichungshistorie und Abstract.
- Volltext, Version 5 – Methodik, Qualitätsvergleich, Modellspeicher und Kernel-Benchmark.
- SamsungLabs/LittleBit – Implementierung, LittleBit-2, unterstützte Modelle und Lizenzangabe.
Quellen geprüft am 9. Oktober 2026. Die vorgeschlagenen Einsatzfelder und der Pilotablauf sind unsere redaktionelle Einordnung. Wir haben LittleBit für diesen Beitrag nicht selbst auf Hardware benchmarked. Das Titelbild ist eine KI-generierte Symbolillustration.
Ähnliche Artikel
DeepSeek V4 Flash, DGX Spark und lokale Inferenz: Was die aktuellen Entwicklungen für Kosten, Datenschutz und KI-Agenten im Unternehmen bedeuten.
Lokale Unternehmen verlieren durch KI-Antworten Sichtbarkeit. So bauen Sie AEO auf: 3 Schritte, Kosten ab 800 EUR/Monat, erste Ergebnisse in 4-8 Wochen…

Fragmentierte AI-Workflows kosten Marketing-Teams 12 Stunden pro Woche → Elvean als lokaler Mac-Client mit Agenten reduziert das auf unter 2 Stunden…